02 记忆即文件
一块装满 Markdown 的
虚拟磁盘
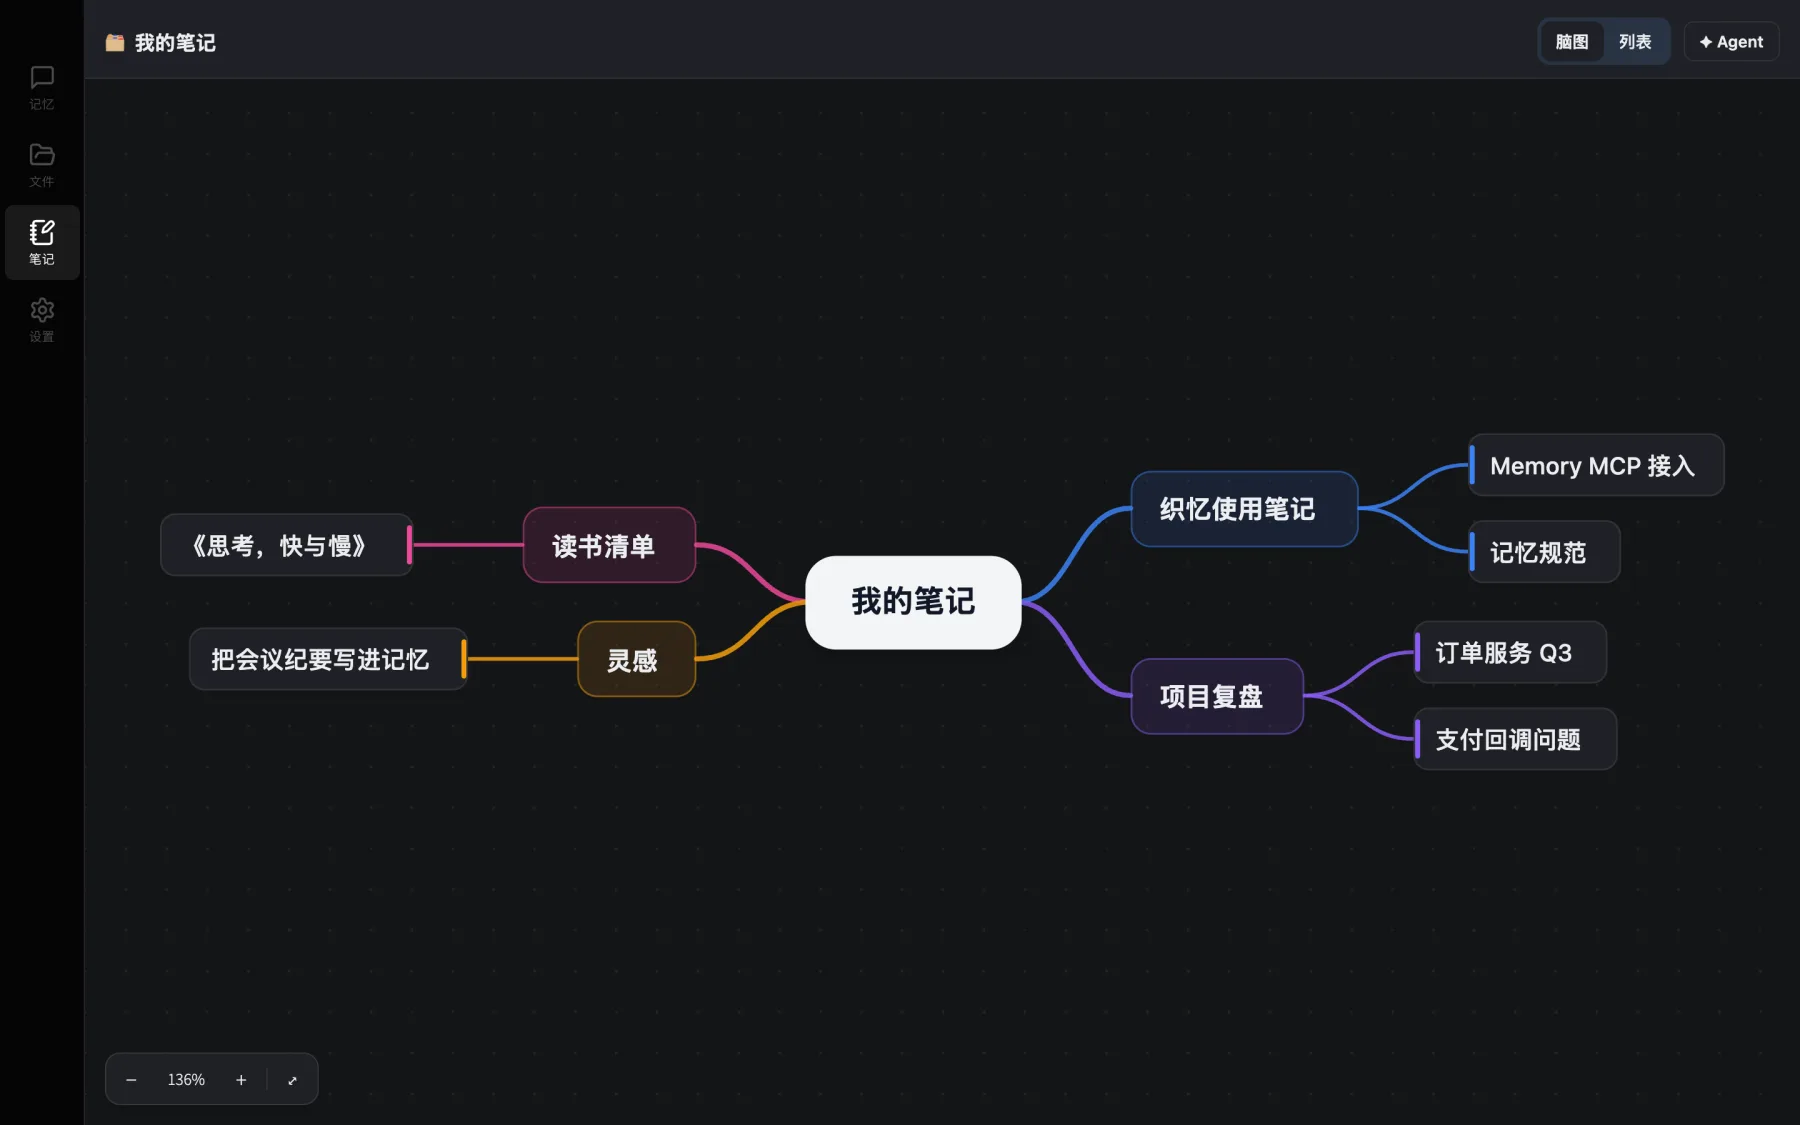
每个记忆库都是一棵独立的目录树,存放在 AgentFS——以 SQLite 为底座的虚拟文件系统。AI 用读写文件的方式整理记忆,你用文件管理器、笔记和思维导图查看与修改它。
- 01
联系人式隔离
工作、生活、每个项目各有一个记忆库,切换起来像切换聊天对象,彼此不串味。
- 02
父子记忆
把一个记忆库挂进另一个记忆库,以
@名称出现在目录中。大项目可以按子模块拆分记忆,再组合使用。 - 03
笔记与思维导图
内置分栏预览的 Markdown 编辑器和思维导图画布,AI 写下的知识随手就能改。
- 04
在访达中打开
macOS 上可把整块记忆磁盘挂载到 Finder,默认只读;也能把某个记忆文件夹链接进你的代码仓库。
03 自我进化
记忆不是存档,
而是一直在学习
织忆把"怎么记"也写成了文件。每个记忆库的 .env 目录保存记忆格式规范与回复风格;开启自进化后,AI 会在工作中持续修订它们,越用越贴合你的习惯。
- 01
三种记忆形态
文本记忆直接落盘;Loop 自进化记忆按 compile / extract 循环反复精炼;Wiki 记忆用多步工作流把原始资料编译成带索引的知识库。
- 02
提示词工作流
把固定流程和好经验写成可复用的工作流,分全局级与记忆级,可设为默认的发送、查询或上下文构建流程。
- 03
记忆核查
AI 写进指定目录的内容会被标记为"未核查",再由定时任务逐条核对,降低错误记忆被反复引用的风险。
- 04
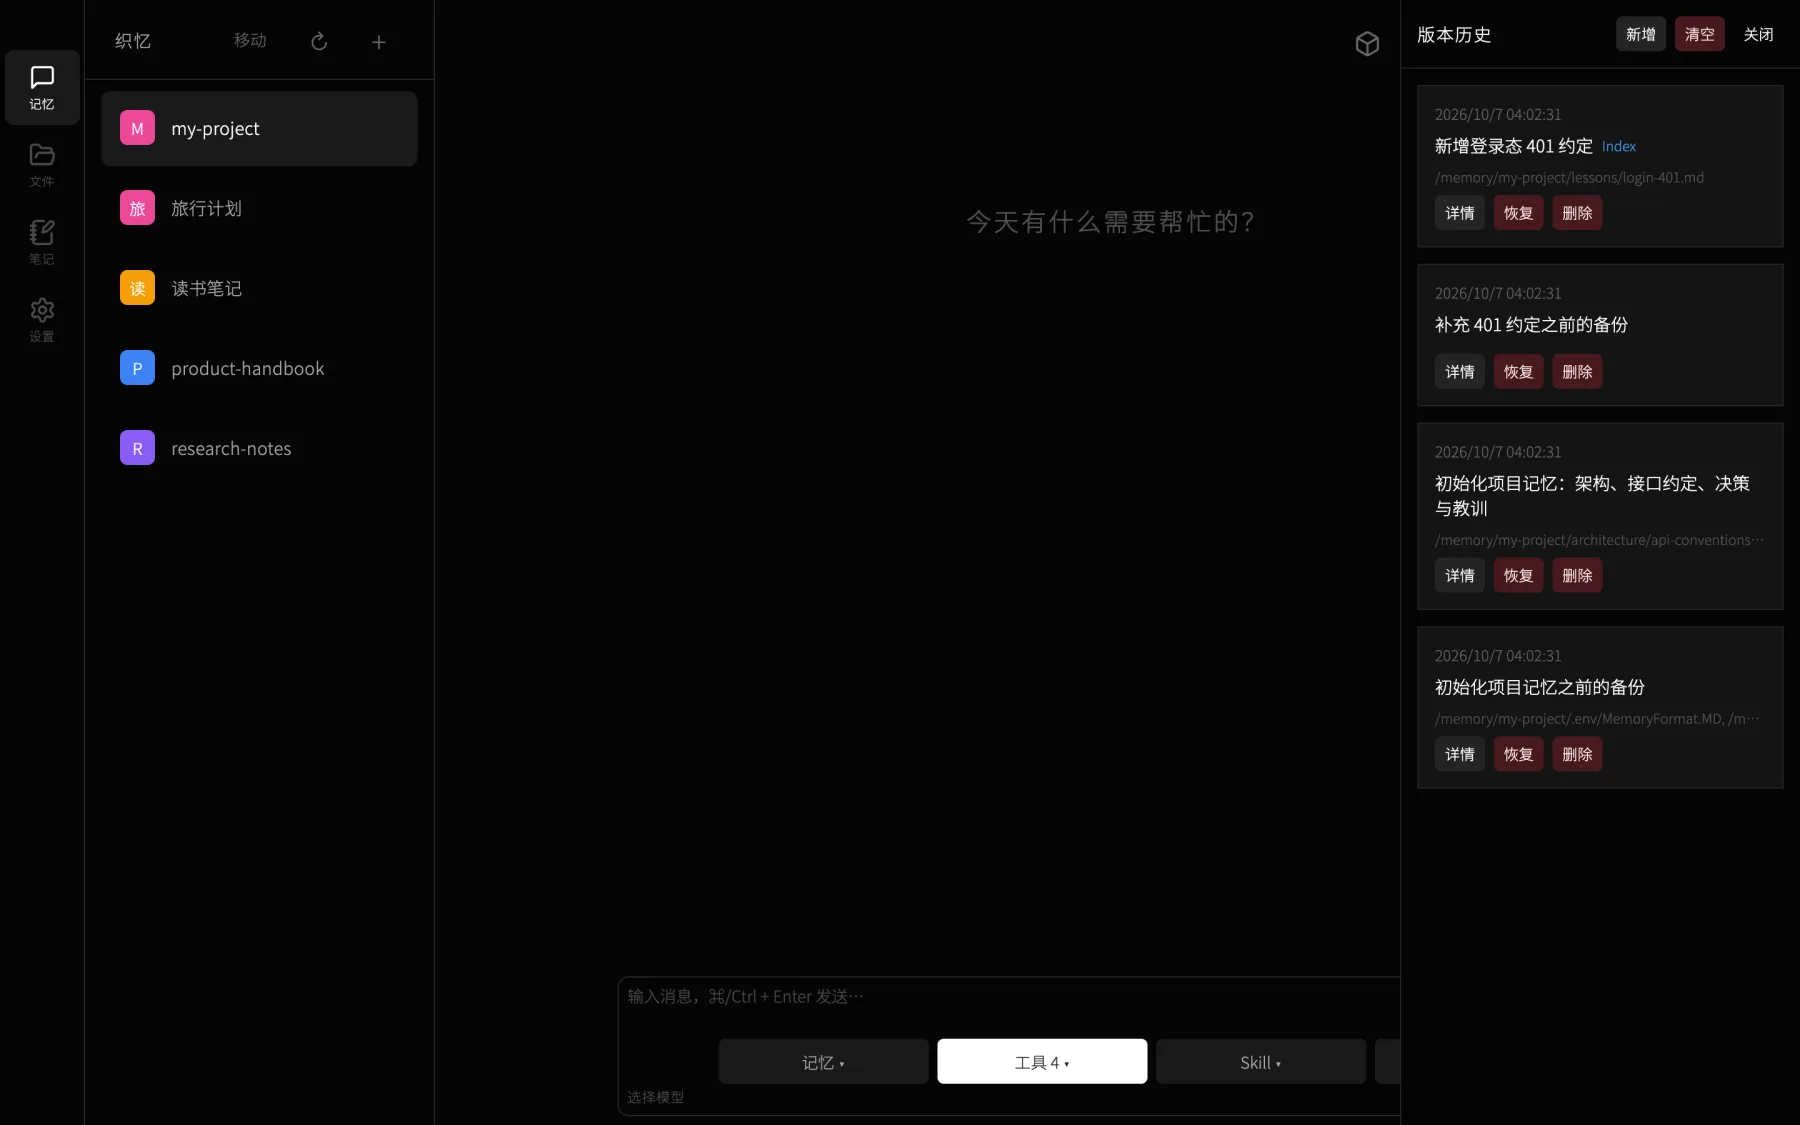
版本与回滚
每次改动都留有版本。可以查看差异、恢复到任意版本,或只撤销其中一次变更。
04 精准检索
像读片一样,
在海量记忆里定位答案
记忆越多,找得准就越重要。织忆在本机完成向量化与检索,再把命中的片段整理成结构化上下文交给模型——数据不必离开你的设备。
- 01
本地 RAG
安装包内置 multilingual-e5-small 嵌入模型(ONNX),向量存入本机 SQLite(sqlite-vec),中英文语义检索不依赖云端嵌入服务。
- 02
上下文构建
buildContext针对一个问题通读记忆,输出背景、相关逻辑、经验教训、风险与建议步骤,作为下一个任务的起点。 - 03
记忆索引快照
选定若干目录,合并为一份带行号导航的只读 Markdown。外部 Agent 按索引分段读取,不必一次塞满上下文窗口。
- 04
上下文压缩
长对话自动压缩历史,保留决策与关键结果;窗口用量在输入框旁实时可见。
05 连接任意 Agent
一个端口,
让所有 Agent 共用一份记忆
织忆内置 Memory MCP 服务(Streamable HTTP)。Claude Code、Codex、Cursor 或你自己的脚本,都用同一组方法查询和写入记忆。
# 查询名为 my-project 的记忆库,并等待结果
curl -s http://127.0.0.1:3901/mcp \
  -H 'Content-Type: application/json' \
  -H 'Accept: application/json, text/event-stream' \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/call",
       "params":{"name":"query_memory","arguments":{
         "memory_name":"my-project",
         "query":"登录模块上次是怎么改的?",
         "wait_for_result":true}}}'
- 01
一键注入 Skill
在设置中为 Claude Code、Codex、Pi coding agent 启用 WaveMemory Skill;Codex 还会自动登记 MCP 地址。不会覆盖你自己写的同名配置。
- 02
完整的方法集
query_memory·update_memory·quick_update_memory·delete_memory·buildContext·update_myself,以及虚拟磁盘工具memory_filesystem_*。写入前自动备份,写完自动提交版本。 - 03
远程访问不必开放端口
通过中继桥接远程调用,本机生成临时访问口令(默认 30 分钟过期),连续输错会被限流。
- 04
反向接入与子代理
织忆也能连接第三方 MCP 服务器,并把任务拆给拥有独立模型的 Subagent 并行处理。
06 跨端随行
从工作站到口袋,
记忆跟着你走
同一份记忆运行在桌面、手机和无头服务器上。局域网内扫码即可同步;需要真实环境时,交给配对的 Bimanus 去执行。
macOS · Windows · Linux
Electron 原生窗口,Apple Silicon 与 Intel、x64 安装包、AppImage / deb。
iPhone · iPad · Android
React Native 原生应用,平板自适应布局,同样内置本地检索。
Linux 无头服务
HTTP + WebSocket,用浏览器访问,适合放在家里的小服务器上常驻。
局域网同步
PC 作同步中心,手机扫码接入。32 分片增量索引、MD5 去重、分批传输、断线续传,并以同步密钥校验设备。
- 01
Bimanus 结对
织忆负责记忆与编排,Bimanus 是它的"手和脚":在配对电脑上调用 Agent、读取文件、执行 Shell,结果再写回记忆。
07 开始使用
三步,唤醒你的 AI 记忆
安装织忆
选择你的平台安装客户端;开发者也可以从源码运行。
配置模型
在「设置 → 模型」添加服务商与 API Key:OpenAI、Anthropic、Google、DeepSeek、智谱、OpenRouter、Ollama,或任意 OpenAI 兼容接口。
新建记忆库,开始对话
给它起一个准确的名字——外部 Agent 会用它作为
memory_name。之后的每一次对话,都会让它更了解你。
织忆会把你的提问和相关记忆发送给你自己配置的模型服务商;除此之外,记忆数据保存在你的设备上。